研究
两项试点研究,同一个问题
AI 音乐检测器在训练时见过的样本上表现很好,遇到新样本就会失效。我分别在音频和乐谱(符号音乐)上验证了这一点。
未见过的生成器上的 AI 音乐检测
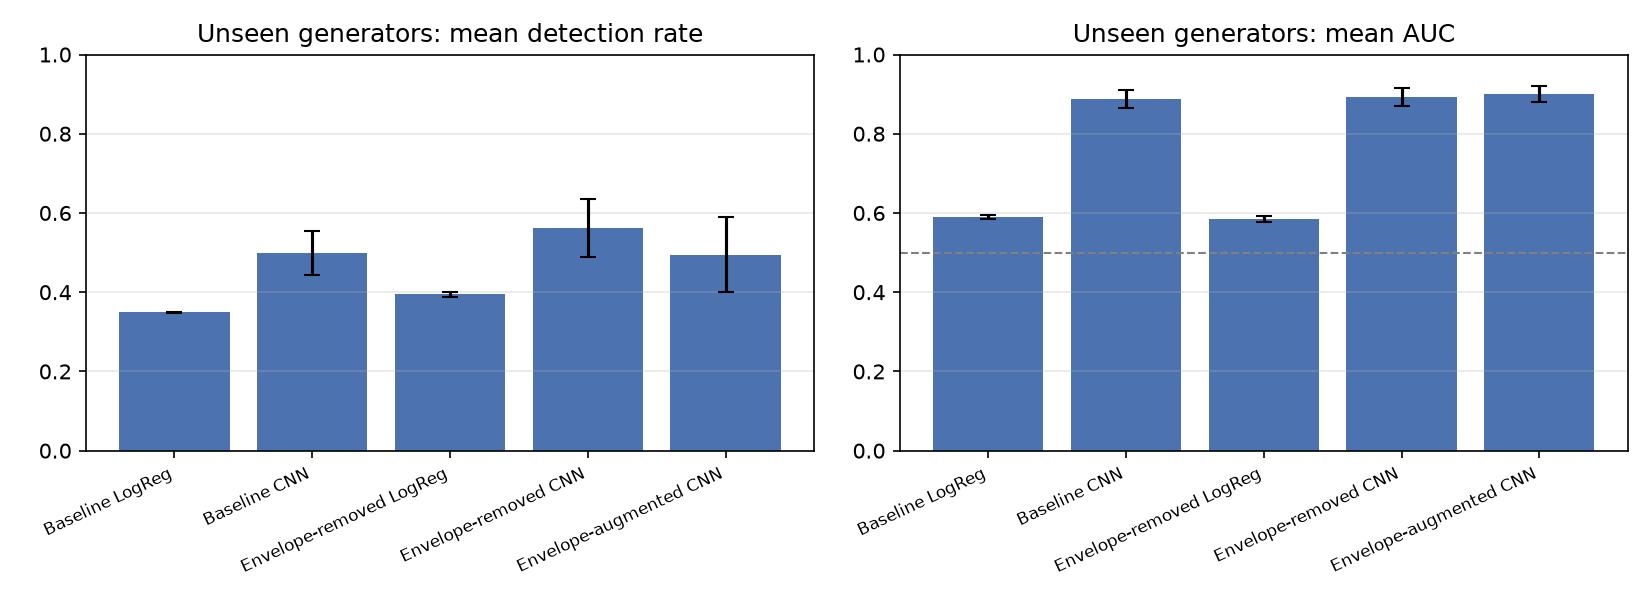
检测器能抓住训练时见过的生成器做的 AI 音乐,但面对从没见过的生成器,只能抓出大约一半。
0.975CNN 在训练时见过的生成器上的平衡准确率
0.50来自没见过的生成器的片段中,被判为 AI 的比例
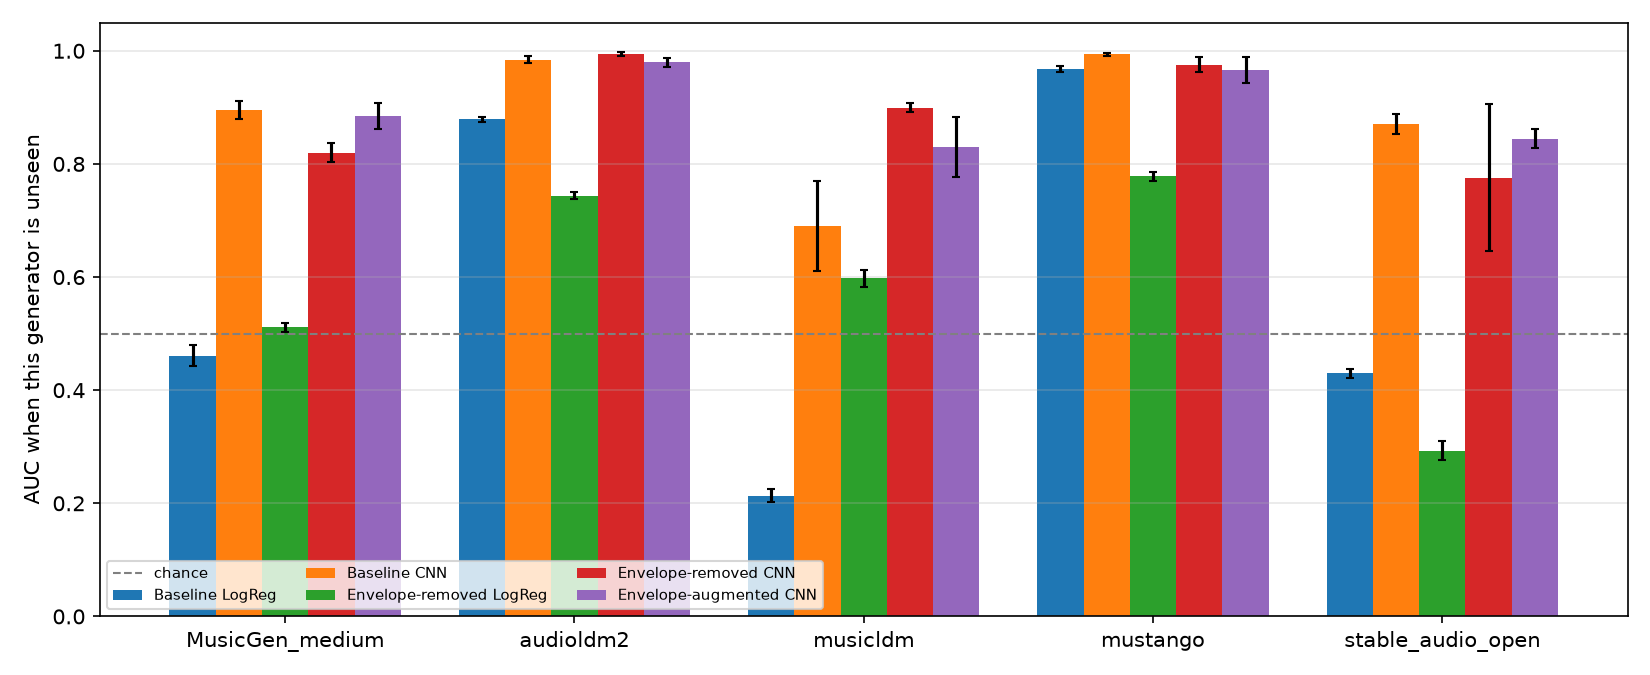
0.21频谱统计检测器在没见过的 MusicLDM 上的 AUC:比真实音乐还“像真的”
- 数据。2,856 段真实 MusicCaps 片段和 27,605 段 AI 片段,来自五个文生音乐模型,都是 10 秒、16 kHz。训练集和测试集按 MusicCaps 的文字描述划分,同一个提示词不会同时出现在两边。
- 测试。每次把一个生成器从训练中拿掉,再用它来测试。这正是新模型发布时流媒体平台面对的情况。
- 没有万能的修法。去掉每段音频的频谱包络后,MusicLDM 的 AUC 从 0.69 升到 0.90,但 MusicGen 和 Stable Audio Open 反而下降。
- 难度和模型架构有关。通过梅尔频谱 VAE 和 HiFi-GAN 解码的生成器之间可以互相迁移;MusicGen 和 Stable Audio Open 一直很难(检出率 0.18–0.34)。
局限:只有 52% 的 MusicCaps 真实片段还能下载;真实片段是有损压缩的 YouTube 音频,AI 片段是无损的;只跑了 3 个随机种子;只测了五个开源生成器。
用拼接仿作测试贝多芬分类器
贝多芬分类器逐个小节地判断,所以用真实贝多芬小节拼出来的仿作能骗过它;看小节之间怎么衔接,就能识破。
0.96复现的 GRU 分类器的 AUC,按作品或按年份划分数据后依然稳定
83–92%拼接片段被判为贝多芬的比例(真实贝多芬:83%)
0.94–0.96衔接检测器区分拼接片段和真实 32 小节片段的 AUC
- 复现。和 Galajda & Hua(2024)一样,用两层 GRU,每个 2 秒的小节提取 27 个特征。留出作品或录音年份后,AUC 仍然是 0.96。
- 拼接。把不同贝多芬作品的小节拼在一起,分数并不会下降。拼接甚至让其他作曲家的音乐被判为贝多芬的比例从 8% 升到 25%。
- 衔接。只看两个小节接口处(调性变化、旋律跳进、音符密度突变、延音)的检测器,能把拼接片段和真实片段分开。
- 同样的泛化缺口。只用随机拼接训练的检测器,遇到挑选过、听起来平滑的拼接,AUC 降到 0.73;反过来训练则降到 0.56。平滑拼接做过了头:平均旋律跳进只有 1.6 个半音,真实贝多芬是 9.1。